Postgres JSON – Überblick
- Postgres bietet native Unterstützung für JSON-Daten
- Erlaubt Kombination aus relationalen mit dokumentenorientierten Daten
- Kann JSON in zwei Typen speichern:
- Textspeicherung: json
- Binärspeicherung: jsonb
Vergleich
- json: speichert Text exakt wie eingegeben, Reihenfolge der Schlüssel bleibt erhalten
- jsonb: binäre Darstellung, Schlüssel sortiert, Duplikate entfernt
- jsonb: unterstützt GIN-Indizes → schnelle Abfragen
- jsonb: etwas langsamer beim Schreiben, deutlich schneller beiLesen/Suchen
- Empfehlung: jsonb für fast alle Anwendungsfälle bevorzugen
Beispieltabelle / JSON-Typen
CREATE TABLE events (
  id        SERIAL PRIMARY KEY,
  ts        TIMESTAMPTZ DEFAULT now(),
  payload   JSONB
);

-- Einfügen von JSON-Daten
INSERT INTO events (payload) VALUES
  ('{"type":"login","user":"alice","ip":"1.2.3.4"}'),
  ('{"type":"order","user":"bob",
     "items":[1,2,3],"total":49.90}');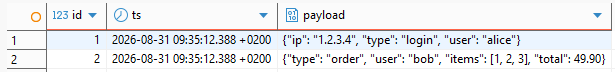
- number: Ganzzahlen und Dezimalzahlen
- string: UTF-8 Zeichenketten
- boolean:
trueoderfalse - null: JSON-Null-Wert
- array: geordnete Liste beliebiger Typen
- object: Schlüssel-Wert-Paare
SELECT '42'::jsonb;           -- Zahl
SELECT '"hello"'::jsonb;      -- String
SELECT 'true'::jsonb;         -- Boolean
SELECT '[1,2,3]'::jsonb;      -- Array
SELECT '{"a":1}'::jsonb;      -- Objekt
Zugriffs-Operatoren
->gibt JSON-Element zurück (als json/jsonb)->>gibt Textwert zurück (als text)#>navigiert Pfad (Array von Strings)#>>navigiert Pfad, gibt Text zurück
SELECT
  payload -> 'user' as u_jsonb,
  payload ->> 'user' as u_text,
  payload #> '{items,0}' as item_jsonb,
  payload #>> '{items,0}' as item_text
FROM events WHERE id = 2;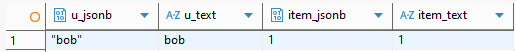
Filtern und Suchen
@>enthält (containment)<@wird enthalten in?Key existiert?|mindestens einer der Keys existiert?&alle Keys existieren
-- Gleichheit ueber ->>
SELECT id, payload
FROM events
WHERE payload->>'type' = 'order';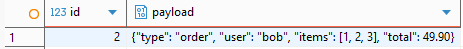
-- Containment @>: enthaelt diesen JSON-Wert
SELECT id, payload
FROM events
WHERE payload @> '{"type":"login"}';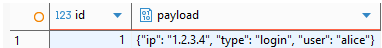
-- Key-Existenz ?
SELECT id, payload
FROM events
WHERE payload ? 'items';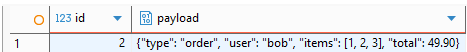
-- Numerischer Vergleich (cast noetig)
SELECT id, payload
FROM events
WHERE (payload->>'total')::numeric > 30;
-- Array-Element enthaelt
SELECT id, payload
FROM events
WHERE payload @> '{"items": [2]}';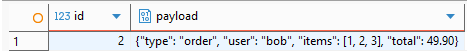
JSON erzeugen
Erzeugungsfunktionen
json_build_object(k,v,...): Objekt aus Schlüssel-Wert-Paarenjson_build_array(...): Array aus beliebigen Wertenjson_agg(): Zeilen zu JSON-Array aggregierenjson_object_agg(k,v): Key-Value-Tabelle zu Objektrow_to_json(): Datenbankzeile als JSON-Objektto_jsonb(): beliebigen Wert zu JSONB konvertieren
Anwendungsfälle
- REST-API-Responses direkt aus SQL generieren
- Report-Exports als JSON
- Daten für Frontend-Anwendungen aufbereiten
Beispieltabelle
CREATE TABLE users (
    id          SERIAL PRIMARY KEY,
    first_name  VARCHAR(100) NOT NULL,
    last_name   VARCHAR(100) NOT NULL,
    birthdate   DATE NOT NULL,
    active      BOOLEAN NOT NULL DEFAULT true
);

INSERT INTO users (first_name, last_name, birthdate, active) VALUES
    ('Anna',   'Schmidt',  '1990-04-15', true),
    ('Peter',  'Müller',   '1985-11-23', true),
    ('Julia',  'Weber',    '1998-07-08', false),
    ('Thomas', 'Fischer',  '1979-02-19', true),
    ('Laura',  'Becker',   '2002-09-30', false),
    ('Michael','Wagner',   '1993-12-05', true);
-- Objekt aus Ausdruecken bauen
SELECT json_build_object(
'name', first_name || ' ' || last_name,
'age', extract(year from age(birthdate))
)
FROM users;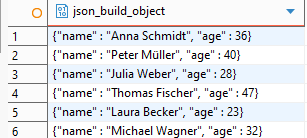
-- Zeilen aggregieren zu JSON-Array
SELECT json_agg(json_build_object(
  'name', first_name || ' ' || last_name,
  'age',  extract(year from age(birthdate)))
)
FROM users
WHERE active = false;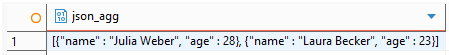
-- Key-Value-Aggregation zu Objekt
SELECT json_object_agg('name', first_name || ' ' || last_name)
FROM users
WHERE active = false;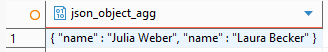
-- Array aus Werten
SELECT json_build_array(1, 'two', true, null);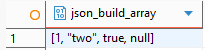
JSONB modifizieren
jsonb_set(target, path, value): Wert setzenjsonb_insert(target, path, value): Element einfügenjsonb_strip_nulls(json): null-Werte entfernen||-Operator: zwei jsonb-Objekte zusammenführen (shallow merge)--Operator: Key entfernen
-- Key entfernen
UPDATE events
  SET payload = payload - 'ip'
WHERE payload->>'type' = 'login';

-- Wert setzen (erstellt Key wenn nicht vorhanden)
UPDATE events
  SET payload = jsonb_set(payload, '{status}', '"processed"')
WHERE id = 2;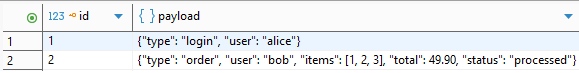
-- Objekte zusammenfuehren (shallow merge)
SELECT '{"a":1,"b":2}'::jsonb || '{"b":99,"c":3}'::jsonb;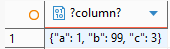
-- Nulls entfernen
SELECT jsonb_strip_nulls('{"a":1,"b":null,"c":null}');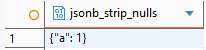
JSON-Funktionen: Entpacken
-- Objekt-Keys und Werte als Zeilen
SELECT key, value
FROM events, jsonb_each(payload)
WHERE id = 1;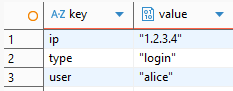
-- Array-Elemente als Zeilen
SELECT item
FROM events, jsonb_array_elements(payload->'items') AS item
WHERE id = 2;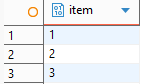
-- Schluessel als Text
SELECT jsonb_object_keys(payload)
FROM events
WHERE id = 1;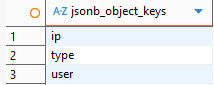
JSON zu Zeilen
- Wandelt JSON-Objekt in PostgreSQL-Zeilentyp um
- Nützlich für Import und Normalisierung von JSON-Daten
json_to_record/json_to_recordsetohne vordefinierten Typ- Fehlende Felder werden mit
NULLgefüllt - Typen werden automatisch konvertiert (z.B. String zu Integer)
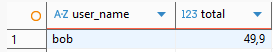
-- Zieltyp definieren
CREATE TYPE order_rec AS (
  user_name text,
  total     numeric
);
-- JSON in Typ umwandeln
SELECT * FROM json_populate_record(
null::order_rec,
'{"user_name":"bob","total":49.90}'
);
-- Array von JSON-Objekten als Tabelle
SELECT * FROM json_to_recordset(
  '[{"id":1,"name":"Alice"},
    {"id":2,"name":"Bob"}]'
) AS t(id int, name text);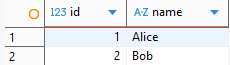
JSONPath – Pfadausdrücke
- JSONPath ist Standard SQL/JSON
- Ausdrücke starten mit
$(Root-Element) .keyfür Objektzugriff,[n]für Array-Zugriff[*]für alle Array-Elemente- Filter-Ausdrücke:
?(@ > 10) - Funktionen:
.type(),.size(),.keyvalue()
-- jsonb_path_query: alle passenden Elemente
SELECT jsonb_path_query(payload, '$.items[*]')
FROM events
WHERE id = 2;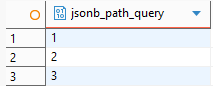
-- Filter: items groesser als 1
SELECT jsonb_path_query(
  payload, '$.items[*] ? (@ > 1)')
FROM events
WHERE id = 2;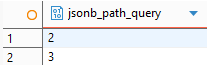
-- jsonb_path_exists: pruefen ob Pfad existiert
SELECT id, payload FROM events
WHERE jsonb_path_exists(payload, '$.type ? (@ == "login")');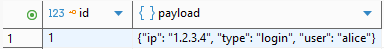
JSONPath: Weitere Abfragen
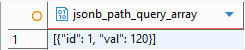
-- Alle Bestellwerte ueber 100
SELECT jsonb_path_query_array(
  '{"orders":[
     {"id":1,"val":120},
     {"id":2,"val":80}]}',
  '$.orders[*] ? (@.val > 100)'
);
-- Erste passende Zeile
SELECT jsonb_path_query_first(
  payload,
  '$.items[*] ? (@ > 1)'
) FROM events
WHERE id = 2;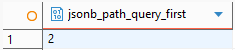
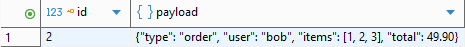
-- Existenz-Check mit Bedingung
SELECT id, payload
FROM events
WHERE jsonb_path_exists(
  payload, '$.total ? (@ > 40)'
);
GIN-Indizes
- GIN (Generalized Inverted Index) indexiert alle Keys und Werte
jsonb_ops(Standard):@>,?,?|,?&- Automatische Nutzung durch Query Planner
- Signifikante Beschleunigung bei
@>und?-Abfragen
-- Standard GIN-Index
CREATE INDEX idx_events_payload
  ON events USING GIN (payload);

-- Path-ops GIN-Index
-- (kompakter, schneller fuer @>)
CREATE INDEX idx_events_payload_path
  ON events USING GIN (payload jsonb_path_ops);

-- Partieller Index auf Subfeld
CREATE INDEX idx_events_type
  ON events ((payload->>'type'));
JSON-Validierung und Constraints
- CHECK-Constraints: einfach, direkt in PostgreSQL
- CHECK auf Key-Existenz (
?) ist performant - Kombination: relationale NOT NULL + JSON CHECK
- CHECK-Constraints werden bei INSERT und UPDATE geprüft
-- CHECK-Constraint fuer JSON-Struktur
ALTER TABLE events ADD CONSTRAINT chk_type
  CHECK (payload ? 'type');

ALTER TABLE events
  ADD CONSTRAINT chk_type_valid
  CHECK (payload->>'type'
         IN ('login','logout','order'));

-- NOT NULL fuer Pflichtfelder innerhalb JSON
ALTER TABLE events ADD CONSTRAINT chk_user
  CHECK (payload ? 'user' AND
         payload->>'user' IS NOT NULL);
Anwendungsfall: API-Logs
CREATE TABLE api_logs (
  id        BIGSERIAL PRIMARY KEY,
  logged_at TIMESTAMPTZ DEFAULT now(),
  data      JSONB
);

-- Fehlerrate der letzten Stunde
SELECT
  data->>'endpoint'          AS endpoint,
  count(*) FILTER
    (WHERE (data->>'status')::int >= 500)
                             AS errors,
  count(*)                   AS total
FROM api_logs
WHERE logged_at >= now() - interval '1h'
GROUP BY endpoint
ORDER BY errors DESC;

-- Index fuer schnelle Endpoint-Suche
CREATE INDEX ON api_logs
  USING GIN (data jsonb_path_ops);
Vorteile
- Keine Schema-Änderung bei neuen Log-Feldern nötig
- Flexible Struktur: verschiedene Log-Typen in einer Tabelle
- Schnelle GIN-Suche nach beliebigen Feldern
- Aggregationen direkt in SQL möglich
- Partition by Time für große Log-Tabellen
Typische Log-Felder
endpoint,method,statusduration_ms,user_idrequest_id,trace_id
Anwendungsfall: Konfigurationsmanagement
CREATE TABLE app_config (
  app     TEXT PRIMARY KEY,
  config  JSONB NOT NULL
);

INSERT INTO app_config VALUES (
  'frontend',
  '{"theme":"dark","locale":"de",
    "features":{
      "beta":true,
      "newDashboard":false}}'
);
-- Feature-Flag abfragen
SELECT config #>> '{features,beta}' as beta_enabled
FROM app_config
WHERE app = 'frontend';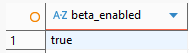
-- Config aktualisieren
UPDATE app_config
  SET config = config || '{"timeout": 30}'
WHERE app = 'frontend';
Vorteile
- Hierarchische Konfigurationen in einem Datensatz
- Feature-Flags einfach verwaltbar
- Versionierung per Zeitstempel-Spalte möglich
Anwendungsfall: Semi-strukturierte Produkte
- Verschiedene Produktkategorien benötigen unterschiedliche Attribute
- Gemeinsame Pflichtfelder relational, Extras als JSONB
- Keine Schema-Änderung bei neuen Attributen
- Hybrides Modell: besser als rein dokumentenorientiert
CREATE TABLE products (
  id       SERIAL PRIMARY KEY,
  name     TEXT NOT NULL,
  price    NUMERIC(10,2),
  category TEXT,
  attrs    JSONB  -- flexible Attribute
);

INSERT INTO products VALUES
  (1,'Laptop',999.00,'electronics',
   '{"brand":"Dell","ram_gb":16,
     "screen_inch":15.6}'),
  (2,'T-Shirt',19.90,'clothing',
   '{"size":"M","color":"blue",
     "material":"cotton"}');

-- Suche nach RAM >= 8 GB
SELECT name, price
FROM products
WHERE (attrs->>'ram_gb')::int >= 8;
Performance-Vergleich
Kurzfazit
- Relational fast immer schneller für komplexe Abfragen und Joins
- JSONB flexibler, aber oft langsamer
Speicher / Struktur
| Relational | JSONB |
|---|---|
|
|
Lese-Performance (SELECT)
| Relational | JSONB |
|---|---|
|
|
Indizierung
| Relational | JSONB |
|---|---|
|
|
Schreib-Performance (INSERT / UPDATE)
| Relational | JSONB |
|---|---|
|
|
Joins / komplexe Queries
| Relational | JSONB |
|---|---|
|
|
Links in Postgres-Doku
| JSON Types | link |
| JSON Functions and Operators | link |
| JSONPATH Type | link |
| SQL/JSON Path Language | link |